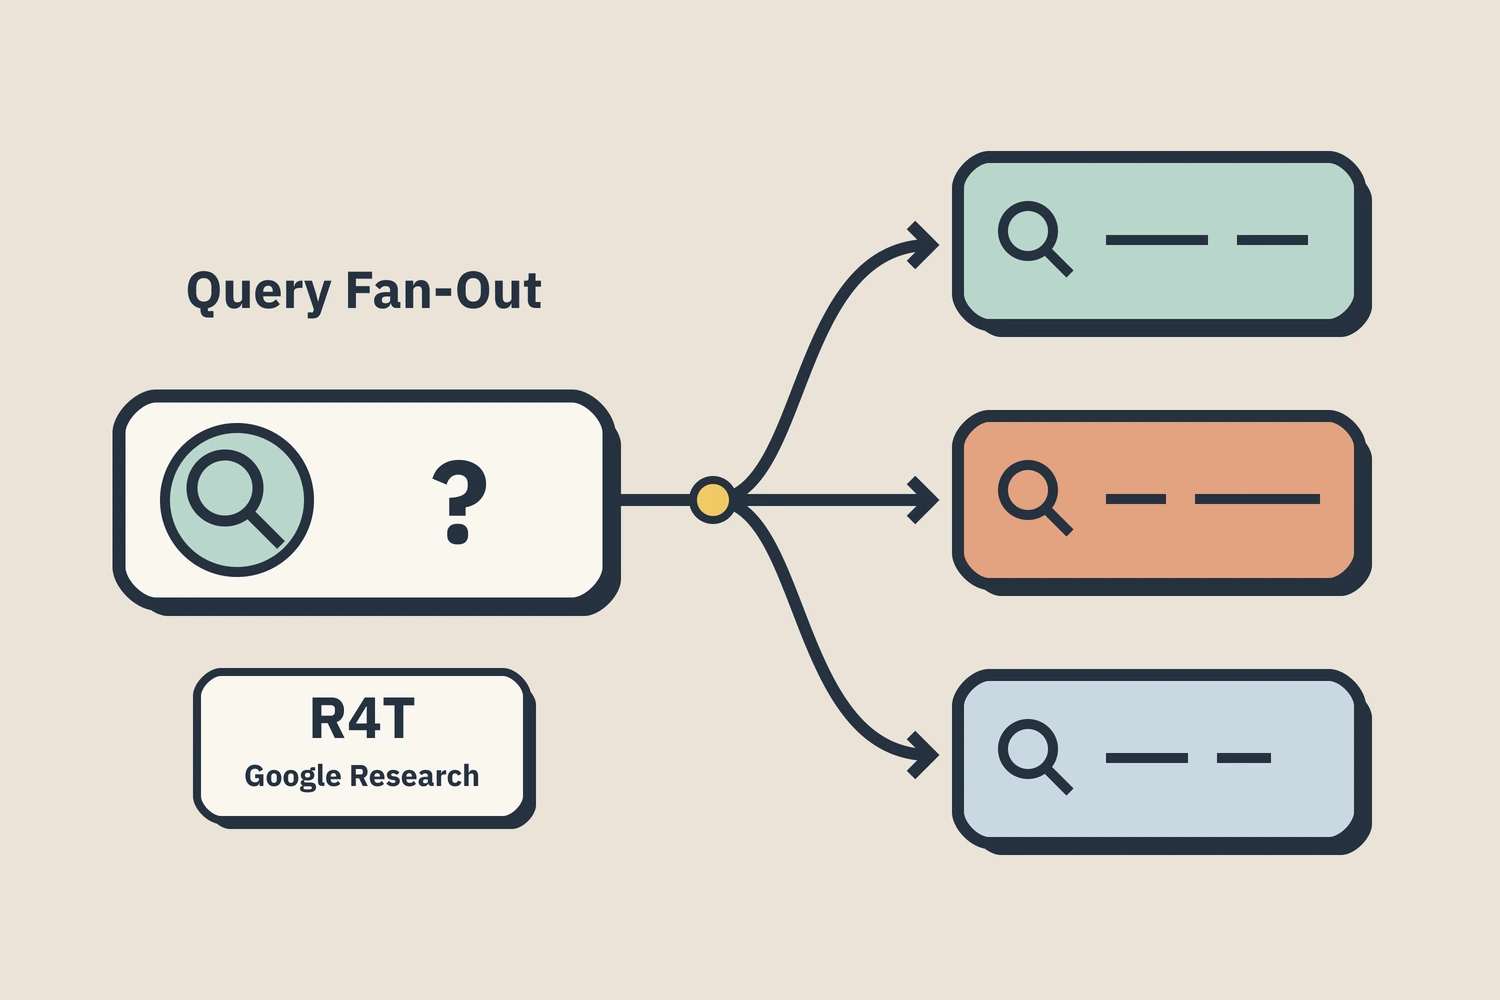
เวลาเรา Search เรื่องง่าย ๆ อย่าง “ร้านกาแฟใกล้ฉัน” Google อาจพอเข้าใจได้จาก Query เดียวว่าควรหาอะไร
แต่ลองเปลี่ยนเป็นคำถามแบบนี้
“ไปญี่ปุ่นเดือนพฤศจิกายน อยาก Hiking ประมาณ 3 วัน ควรไปที่ไหน อากาศเป็นอย่างไร และต้องเตรียมอะไรบ้าง?”
ถ้าเป็น Search แบบเดิม เราอาจต้องแยกหาทีละเรื่อง
สถานที่ Hiking
สภาพอากาศ
ฤดูกาล
การเดินทาง
อุปกรณ์ที่ต้องเตรียม
หรือเส้นทางที่เหมาะกับระดับความสามารถของเรา
แต่ใน AI Search ระบบสามารถพยายามแตกคำถามใหญ่หนึ่งคำถามออกเป็นคำถามย่อยหลายเรื่อง ค้นหาข้อมูลเหล่านั้นพร้อมกัน แล้วนำกลับมาประกอบเป็นคำตอบเดียว
Google เรียกเทคนิคนี้ว่า Query Fan-Out
และล่าสุด Google Research เปิดเผยงานวิจัยใหม่ชื่อ Retrieve-for-Train หรือ R4T ที่พยายามทำ Query Fan-Out ให้เร็วขึ้น ใช้ทรัพยากรน้อยลง และยังรักษาคุณภาพของผลลัพธ์ที่ได้จากการค้นหาหลายทิศทางพร้อมกัน Google Research
จากผลการทดลองของ Google Research วิธี R4T-Diffusion สามารถลด Latency ได้อย่างมาก และทำงานเร็วกว่า Autoregressive Approach ที่นำมาเปรียบเทียบประมาณ 12–20 เท่า ในชุดการทดลองของงานวิจัย Google Research
ฟังดู Technical มาก และในระดับหนึ่งก็ Technical จริงครับ
แต่สิ่งที่ผมสนใจไม่ใช่ว่า Diffusion Model ทำงานเร็วขึ้นกี่เท่า
สิ่งที่น่าสนใจกว่าสำหรับคนทำ SEO คือ Google กำลังลงทุนกับระบบที่ทำให้ Search สามารถสำรวจหลายมิติของความต้องการจาก Query เดียวได้เร็วและถูกลง
ถ้าทิศทางนี้ถูกนำไปใช้ในระบบ Search มากขึ้น สิ่งที่เราควรถามอาจไม่ใช่แค่
“เราจะ Rank Keyword นี้ได้อย่างไร?”
แต่ต้องถามเพิ่มว่า
“จากความต้องการนี้ มีคำถามหรือ Subtopic อะไรอีกบ้างที่ Search System อาจต้องไปหาคำตอบ?”
Query Fan-Out คืออะไร?
Query Fan-Out คือเทคนิคที่ระบบนำคำถามหลักของ User ไปแตกออกเป็น หลาย Related Queries เพื่อค้นหาข้อมูลจากหลาย Subtopic หรือหลายแหล่งพร้อมกัน
Google ระบุอย่างชัดเจนว่า AI Overviews และ AI Mode สามารถใช้ Query Fan-Out เพื่อค้นหา Supporting Information เพิ่มเติมและหาเว็บไซต์ที่เกี่ยวข้องกับหลายมิติของคำถามได้ Google for Developers
ลองใช้คำถามง่าย ๆ เช่น
“ไป Hiking ที่ญี่ปุ่นช่วงปลายปีที่ไหนดี?”
ระบบอาจต้องการข้อมูลเพิ่มเติมหลายประเภท เช่น
- เส้นทาง Hiking ที่เหมาะกับเดือนนั้น
- สภาพอากาศ
- พื้นที่ที่ปิดในฤดูหนาว
- การเดินทางจากเมืองใหญ่
- อุปกรณ์ที่ควรเตรียม
- ระดับความยากของแต่ละเส้นทาง
- ประสบการณ์ทางวัฒนธรรมหรือสถานที่ใกล้เคียง
รายการนี้เป็นเพียงตัวอย่างเพื่ออธิบายแนวคิด ไม่ใช่ชุด Query จริงที่ Google เปิดเผยว่าใช้กับคำถามนี้
ประเด็นสำคัญคือ Search System ไม่จำเป็นต้องมอง Original Query เป็นคำถามเดียวอีกต่อไป
มันสามารถแตก Intent ออกมาเป็นหลาย Retrieval Problems แล้วค่อยนำสิ่งที่พบกลับมาประกอบกัน
ทำไม Query Fan-Out ถึงมีปัญหาเรื่องความเร็ว?
ฟังดูเหมือนงานที่ Large Language Model ทำได้อยู่แล้ว
เราให้คำถามหนึ่งข้อ แล้วให้ Model ช่วยคิดว่าเกี่ยวข้องกับเรื่องอะไรอีกบ้าง
แต่ปัญหาเกิดขึ้นเมื่อสิ่งนี้ต้องทำในระดับ Search Engine
Google Search ต้องให้คำตอบเร็วมาก และต้องรองรับ Query จำนวนมหาศาลพร้อมกัน
ถ้าทุกครั้งที่มี User Search ระบบต้องให้ LLM ขนาดใหญ่คิดทีละขั้น สร้าง Subquery หลายชุด ตรวจว่าคำเหล่านั้นไม่ซ้ำกัน และยังต้องตรวจด้วยว่าสิ่งที่สร้างขึ้นมาสามารถ Retrieve ข้อมูลจริงจาก Database ได้หรือไม่ ต้นทุนด้านเวลาและ Computing จะสูงมาก
Google Research อธิบายว่าการใช้โมเดลแบบ Autoregressive สำหรับ Fan-Out มีข้อจำกัดสำคัญเรื่อง Latency เพราะต้องสร้าง Output แบบต่อเนื่องทีละ Token และอาจต้องใช้ Reasoning จำนวนมากเพื่อวางแผน Subqueries ก่อนจะได้ผลลัพธ์สุดท้าย Google Research
สำหรับ Chatbot เราอาจยอมรอเพิ่มอีกสองสามวินาทีได้
แต่สำหรับ Search Bar ที่ต้องทำงานในระดับ Production สิ่งนี้กลายเป็น Bottleneck
R4T หรือ Retrieve-for-Train แก้ปัญหานี้อย่างไร?
แนวคิดของ R4T คือ ย้ายงานที่หนักออกจากตอนที่ User กำลังรอ
แทนที่จะให้ Model ขนาดใหญ่ต้องคิดใหม่ทุกครั้ง Google Research ใช้ Reinforcement Learning เพื่อเรียนรู้ก่อนว่า Fan-Out ที่ดีควรมีลักษณะอย่างไร จากนั้นนำสิ่งที่เรียนรู้นั้นไปสร้าง Training Data และ Train Model ที่เล็กกว่าให้สามารถสร้างผลลัพธ์หลายทิศทางพร้อมกันได้เร็วขึ้น Google Research
ถ้าลดความ Technical ลง กระบวนการมีประมาณ 3 ขั้น
1. ให้ Model เรียนรู้ก่อนว่า Fan-Out ที่ดีเป็นอย่างไร
Google ใช้ Reinforcement Learning ให้ Model ฝึกสร้างชุด Subqueries และให้ Reward ตามคุณภาพของชุดผลลัพธ์ทั้งหมด
ไม่ได้ดูเพียงว่าแต่ละ Query เกี่ยวข้องหรือไม่ แต่ดูว่าทั้งชุดทำงานร่วมกันดีแค่ไหน
2. ใช้ Model ที่เรียนรู้แล้วสร้าง Training Data
เมื่อ Model เริ่มรู้ว่า Fan-Out ที่ดีควรเป็นแบบไหน ก็ให้มันสร้างตัวอย่างจำนวนมากแบบ Offline
จึงไม่ต้องทำกระบวนการหนักนี้ใหม่ทุกครั้งที่ User Search
3. Train Diffusion Retriever ที่เล็กกว่าให้สร้างผลลัพธ์พร้อมกัน
Model ขนาดเล็กกว่าสามารถสร้างหลาย Retrieval Directions แบบ Parallel แทนการสร้าง Subquery ทีละคำ
ในงานวิจัย Google ใช้ Diffusion Model ขนาดประมาณ 53.9 ล้าน Parameters และรายงานว่าในชุดการทดลองสามารถลด Latency จากเกือบ 50 วินาทีในบาง Large-batch Scenario เหลือระดับต่ำกว่า 1 วินาทีถึงไม่กี่วินาที Google Research
ตัวเลขเหล่านี้ควรอ่านในบริบทว่าเป็น ผลการทดลองของงานวิจัย ไม่ใช่ความเร็วของ Google Search ที่ User ใช้งานอยู่ในปัจจุบัน
Query Fan-Out ที่ดีไม่ใช่แค่สร้าง Synonym หลายคำ
ผมคิดว่าส่วนนี้น่าสนใจที่สุดสำหรับคนทำ Content
Google Research พบปัญหาหนึ่งที่เรียกว่า Paraphrastic Collapse
ถ้าเราให้ LLM ทั่วไปช่วยแตก Query มันมีแนวโน้มสร้างคำที่ความหมายคล้ายกันมากเกินไป
เช่นจากคำว่า
Bohemian festival style
ระบบอาจสร้าง
bohemian festival fashion
และ
bohemian festival clothes
คำดูต่างกัน แต่จริง ๆ แล้วกำลังพา Search ไปในทิศทางเดียวกัน
สิ่งที่ Query Fan-Out ต้องการมากกว่าคือ หลายมุมที่เกี่ยวข้อง แต่ไม่ได้ซ้ำกัน
Google Research จึงใช้ Reward หลัก 3 ด้านในการ Train ระบบ R4T Google Research
Groundedness
สิ่งที่ระบบแตกออกมาต้องยังเชื่อมกับข้อมูลที่สามารถ Retrieve ได้จริง
ไม่ใช่สร้าง Query ที่ฟังดูดี แต่ไม่มีอะไรอยู่ใน Database รองรับ
Diversity
ชุด Query ต้องมีความหลากหลาย
ไม่ใช่เปลี่ยนคำเล็กน้อยแล้วค้นหาเรื่องเดิมซ้ำหลายครั้ง
Alignment
แม้จะแตกออกไปหลายทิศทาง แต่ยังต้องเกี่ยวข้องกับ Intent ตั้งต้น
ไม่ใช่ Explore จนหลุดจากคำถามของ User
สามเรื่องนี้ทำให้ Query Fan-Out ต่างจากการเอา Keyword ไปหา Synonym เพิ่ม
สิ่งที่ระบบต้องการคือ Coverage ที่กว้างขึ้นโดยที่แต่ละส่วนยังช่วยตอบความต้องการเดียวกัน
แล้ว Google ใช้ R4T ใน AI Mode แล้วหรือยัง?
ตรงนี้ต้องแยก Fact กับ Interpretation ให้ชัดครับ
สิ่งที่ Google ยืนยันแล้ว
Google Search ใช้ Query Fan-Out ใน AI features อย่าง AI Mode และ AI Overviews ได้อยู่แล้ว Google for Developers
และ Google Research ได้พัฒนา R4T เพื่อแก้ปัญหา Fan-Out Retrieval ให้มีประสิทธิภาพและ Scale ได้ดีขึ้น โดยอธิบายว่าวิธีนี้เหมาะกับ Production Retrieval System Google Research
สิ่งที่ Google ยังไม่ได้ยืนยัน
Google ยังไม่ได้ประกาศว่า R4T-Diffusion ตัวนี้ถูก Deploy เข้า Google Search หรือ AI Mode ที่เราใช้งานอยู่แล้ว
ดังนั้นผมจะไม่เรียกเรื่องนี้ว่า
“Google Search Algorithm Update”
และยังไม่ควรสรุปว่า Google Search ตอนนี้ใช้ R4T อยู่เบื้องหลัง
สิ่งที่เรามีคือ งานวิจัยที่แสดงทิศทางว่าการทำ Query Fan-Out สามารถถูกพัฒนาให้เร็วและประหยัดขึ้นได้มาก
Search Engine Journal เองก็ชี้ประเด็นเรื่องความพร้อมระดับ Production แต่การเชื่อมโยงไปถึง Deployment ใน Google Search ยังเป็นการตีความ ไม่ใช่สิ่งที่ Google ยืนยัน
แล้วเรื่องนี้เกี่ยวอะไรกับ SEO?
ถ้า R4T ยังไม่ได้ยืนยันว่าใช้ใน Google Search ทำไมคนทำ SEO ต้องสนใจ?
เพราะ Query Fan-Out ใช้อยู่ใน Google AI Search แล้ว
R4T เพียงทำให้เราเห็นชัดขึ้นว่าทีมวิจัยของ Google กำลังให้ความสำคัญกับการทำ Retrieval แบบหลายทิศทางให้เร็วและ Scale ได้มากขึ้น
SEO implication จึงไม่ได้มาจาก R4T โดยตรงทั้งหมด แต่มาจากวิธีที่ Query Fan-Out เปลี่ยนรูปแบบการ Retrieve Content
1. Keyword เดียวอาจไม่สะท้อนโอกาสในการถูกค้นพบทั้งหมด
ใน Classic Search เรามักเริ่ม Content Planning จาก Keyword
เช่นบทความหนึ่งอาจ Target
Performance Max คืออะไร
จากนั้นเราอาจมี Secondary Keywords อย่าง
- PMax
- Google Performance Max
- Performance Max Campaign
วิธีนี้ยังมีประโยชน์อยู่ครับ
แต่ถ้า AI Search ใช้ Query Fan-Out ระบบอาจไม่ได้ถามเพียงว่า
หน้าไหนตอบว่า Performance Max คืออะไรได้ดีที่สุด
มันอาจต้อง Retrieve ข้อมูลเกี่ยวกับ
- Performance Max กับ Search ต่างกันอย่างไร
- PMax เหมาะกับ Lead Generation หรือไม่
- Search Themes ทำงานอย่างไร
- Conversion Tracking สำคัญแค่ไหน
- PMax ใช้กับ E-commerce อย่างไร
- AI Max ต่างจาก PMax หรือไม่
เว็บไซต์หนึ่งอาจไม่ได้ Rank อันดับสูงสุดสำหรับ Original Query แต่ยังมีโอกาสถูก Retrieve เพื่อช่วยตอบ Subtopic บางส่วนได้
Google เองระบุว่า Query Fan-Out ช่วยให้ AI features สามารถหา Supporting Pages ที่กว้างและหลากหลายกว่าการค้นหาแบบ Classic Search ได้
2. Topic Coverage สำคัญขึ้น แต่ไม่ได้แปลว่าต้องสร้าง 100 หน้า
ตรงนี้เป็นกับดักที่ผมคิดว่าวงการ SEO มีโอกาสเดินเข้าไปง่ายมาก
เมื่อเรารู้ว่า AI แตก Query ออกเป็นหลาย Subqueries เราอาจคิดว่า
ถ้าอย่างนั้นก็หา Fan-Out Queries ทั้งหมด แล้วสร้างหน้าให้ครบทุก Query
ผมไม่แนะนำวิธีคิดนี้
Google เองเตือนโดยตรงว่าไม่ควรสร้าง Content แยกจำนวนมากเพื่อจับทุก Possible Query Variation หรือ Fan-Out Query หากจุดประสงค์หลักคือ Manipulate Ranking หรือ AI Visibility
การสร้าง Page จำนวนมากที่ไม่มี Value ใหม่อาจเข้าข่าย Scaled Content Abuse ได้ Google for Developers
ดังนั้นการเข้าใจ Query Fan-Out ไม่ควรพาเรากลับไปทำ
Keyword Farm เวอร์ชัน AI
สิ่งที่ควรทำคือใช้ Fan-Out เป็นเครื่องมือช่วยคิดว่า Customer ต้องเข้าใจเรื่องอะไรอีกบ้างเพื่อทำ Progress ต่อ
ถ้าเรื่องเหล่านั้นอยู่ใน Intent เดียวกัน ก็อาจควรรวมอยู่ใน Content เดียวกัน
แต่ถ้า Intent ต่างกันจริง ค่อยแยกออกเป็นคนละหน้า
3. Content ที่ตอบหลาย Supporting Angles อาจมี Retrieval Opportunity มากขึ้น
ลองกลับมาที่บทความ Performance Max ที่เราเพิ่งทำ
ถ้าเขียนเพียง
Performance Max คืออะไร
บทความก็อาจมี Definition, ข้อดี ข้อเสีย และจบ
แต่คนที่กำลังพยายามตัดสินใจว่าจะใช้ PMax หรือไม่มักต้องการรู้อีกหลายเรื่อง
Search หรือ PMax
Lead Generation ใช้ได้ไหม
Search Themes คืออะไร
Negative Keywords ทำได้หรือไม่
Final URL Expansion ควรเปิดไหม
วัด Lead Quality อย่างไร
การตอบเรื่องเหล่านี้ไม่ได้ทำเพื่อ “จับ Fan-Out Keyword”
แต่เพราะมันคือคำถามที่เกิดขึ้นตามธรรมชาติใน Customer Journey เดียวกัน
ถ้า AI Search แตก Query ไปในทิศทางเหล่านี้ Content ก็มีโอกาส Relevant กับหลาย Retrieval Path มากขึ้นโดยธรรมชาติ
นี่ต่างจากการยัด Keyword ลงหน้าเดิม
เพราะสิ่งที่เพิ่มคือ Coverage ของความต้องการ ไม่ใช่ Density ของคำ
4. First-hand Experience มีค่ามากขึ้นเมื่อข้อมูลพื้นฐานกลายเป็น Commodity
อีกเรื่องที่ผมคิดว่าสำคัญคือ ถ้า AI Search สามารถ Retrieve จากหลายแหล่งพร้อมกันได้ง่ายขึ้น Content ที่เพียงอธิบาย Definition เดียวกับคนอื่นอาจมีเหตุผลให้ถูกเลือกน้อยลง
ลอง Search เรื่อง PMax
เว็บไซต์หลายร้อยแห่งอธิบายได้ว่า
PMax คืออะไร
ใช้ Channel ไหน
มี Asset Group อย่างไร
ข้อมูลเหล่านี้หาได้ง่ายมาก
แต่ข้อมูลที่หาได้ยากกว่าคือ
- สิ่งที่ Practitioner เจอจริง
- สิ่งที่ทดลองแล้วได้ผลหรือไม่ได้ผล
- Business Constraint
- Original Data
- Case
- Screenshot
- Observation
- ความเห็นจากคนที่ใช้ระบบจริง
Google เองแนะนำเรื่อง AI Search ว่า Content ที่มี Unique Perspective, Original Experience และ Non-commodity Information มีแนวโน้มสร้างคุณค่าระยะยาวมากกว่าการนำข้อมูลทั่วไปที่หาได้จากที่อื่นมาเขียนใหม่ Google for Developers
นี่ตรงกับ Direction ที่ C & S กำลังพยายามทำกับบทความช่วงหลัง
เราไม่ได้ต้องการเขียนแค่
“Feature นี้คืออะไร?”
แต่พยายามเพิ่มว่า
“จากที่เราเคยใช้หรือเคยเจอจริง สิ่งนี้มีความหมายอย่างไร?”
Query Fan-Out ทำให้ Keyword Research หมดความหมายไหม?
ไม่ครับ
ผมยังคิดว่า Keyword Research สำคัญมาก
เพราะ Keyword Data ช่วยให้เราเห็น
- คนใช้ภาษาอย่างไร
- Search Demand มีเท่าไร
- Intent เป็นแบบไหน
- Topic ไหนมี Commercial Value
- Competition มากน้อยแค่ไหน
สิ่งที่เปลี่ยนคือ Keyword Research ไม่ควรเป็นจุดจบของ Content Brief
เดิมเราอาจทำ Brief แบบนี้
Primary Keyword
Secondary Keywords
Search Volume
Outline
ผมคิดว่าใน AI Search เราควรเพิ่มอีก Layer
Primary Intent
Customer Problem
Questions ที่คนต้องตอบต่อ
Supporting Subtopics
Evidence หรือ Experience ที่เรามี
Query Fan-Out ทำให้เราเห็นชัดขึ้นว่าคำถามหนึ่งข้อไม่ได้อยู่โดด ๆ
คนมีคำถามต่อ
และ Search System เองก็กำลังพยายามเข้าใจคำถามต่อเหล่านั้นมากขึ้นเช่นกัน
ถ้าอย่างนั้น Content Workflow ควรเปลี่ยนอย่างไร?
ผมยังไม่คิดว่าเราต้องมี Framework ใหม่ชื่อ “R4T SEO”
หลายอย่างคือหลัก Content Strategy ที่ควรทำอยู่แล้ว เพียงแต่ Query Fan-Out ทำให้เหตุผลของมันชัดขึ้น
1. เริ่มจาก Customer Problem ไม่ใช่ Keyword อย่างเดียว
Keyword บอกเราว่าคน Search อะไร
แต่ต้องถามต่อว่า ทำไมเขาถึง Search เรื่องนี้
เช่นคน Search
Google Ads ราคา
เขาอาจไม่ได้ต้องการรู้แค่ค่า Agency Fee
จริง ๆ เขาอาจกำลังถามว่า
งบเท่าไรถึงเริ่มได้
Google คิดเงินอย่างไร
ควรตั้ง Budget แค่ไหน
ต้องจ่าย Agency เท่าไร
และสุดท้ายโฆษณาคุ้มหรือไม่
ถ้าเราตอบเพียง “ราคาเริ่มต้นเท่าไร” เราอาจยังไม่ช่วย Customer ทำ Progress ได้มากพอ
2. หา Questions และ Supporting Topics
ใช้ข้อมูลจาก
- Keyword Research
- SERP
- People Also Ask
- Search Terms
- Customer Conversations
- Sales Questions
- Client Experience
เพื่อเข้าใจว่าคำถามหลักมีอะไรตามมา ไม่ต้องสร้างหน้าให้ทุกคำถาม แต่ใช้มันช่วยออกแบบ Coverage
3. รวมเรื่องที่อยู่ใน Intent เดียวกันให้ครบพอ
ถ้าคนที่ Search Performance Max มีโอกาสถามเรื่อง Search Themes ต่อ เรื่องนั้นสามารถอยู่ในบทความเดียวกันได้
แต่ถ้าคำถามเปลี่ยนไปเป็น
รับทำ Performance Max ราคาเท่าไร
นี่อาจเป็น Commercial Intent ที่ควรอยู่หน้า Service มากกว่า
การรู้ว่าอะไรควรรวมและอะไรควรแยกยังเป็น Information Architecture แบบเดิม
Query Fan-Out ไม่ได้เปลี่ยนหลักนี้
4. อย่าทำ Thin Content เพียงเพื่อครอบคลุม Query
การมี 50 หน้าไม่ได้แปลว่ามี Topical Authority มากกว่า 10 หน้าที่มีประโยชน์จริง
Google ระบุชัดว่าปริมาณ Content จำนวนมากไม่ได้ทำให้เว็บไซต์มีคุณภาพหรือ Relevant มากขึ้นโดยอัตโนมัติ Google for Developers
ก่อนสร้างหน้าใหม่จึงควรถามว่า
Page นี้มี Job ของตัวเองจริงหรือเปล่า?
5. เพิ่ม Evidence ที่หาไม่ได้จาก SERP ทั่วไป
ถ้ามี
- Case
- Experiment
- Customer Observation
- First-hand Experience
- Original Screenshot
- Data
- Process
ให้ใช้มัน
เพราะส่วนนี้ต่างหากที่ทำให้ Content ของเราไม่กลายเป็นแค่ Summary ของหน้าอื่น
Query Fan-Out กับ SEO Content Engine ของ C & S เกี่ยวกันอย่างไร?
จริง ๆ แล้วสิ่งที่เรากำลังทำกับ SEO Content Engine อยู่ตอนนี้ค่อนข้างสอดคล้องกับแนวคิดนี้อยู่แล้ว
เราไม่ได้เริ่มจาก
Keyword แล้วสั่ง AI เขียน Article
แต่เริ่มจาก
Business Objective
Search Demand
SERP
Customer Problem
Content Gap
First-hand Experience
แล้วค่อยสร้าง Article
สิ่งที่ Query Fan-Out เพิ่มเข้ามาคืออีกคำถามหนึ่ง
จาก Original Intent นี้ มี Supporting Question อะไรที่ Search System หรือ Customer อาจต้องสำรวจต่อ?
ผมคิดว่านี่ควรกลายเป็นอีกหนึ่ง Layer ใน Content Brief ของเรา ไม่ใช่เพื่อ Optimize ให้ R4T
แต่เพื่อช่วยให้ Content เข้าใจ Problem Space ของลูกค้า ครบขึ้น
R4T ไม่ได้มีประโยชน์เฉพาะกับ Search
อีกจุดที่น่าสนใจคือ Google Research ไม่ได้วาง R4T ไว้เฉพาะ Web Search
แนวคิด Set-valued Retrieval สามารถใช้กับระบบอื่นที่ต้องสร้างชุดผลลัพธ์ที่หลากหลายและทำงานร่วมกัน เช่น
- Recommendation Systems
- Exploratory Retrieval
- Planning
- Creative Generation
งานทดลองของ R4T เองใช้ทั้งข้อมูลด้าน Fashion และ Music ไม่ได้ทดลองกับ Google Search Index โดยตรง Google Research
ตรงนี้ยิ่งเป็นเหตุผลว่าทำไมเราไม่ควรรีบเรียกมันว่า SEO Algorithm Update
มันเป็น Research Framework ที่สะท้อนโจทย์ใหญ่กว่านั้น คือ
ทำอย่างไรให้ AI สามารถค้นหา “ชุดข้อมูลที่ดี” แทนที่จะหาคำตอบที่ดีที่สุดเพียงหนึ่งรายการ
แล้ว SEO ต้องทำอะไรกับ R4T วันนี้?
ถ้าถามแบบตรงที่สุด
ยังไม่มีอะไรที่ต้อง Optimize สำหรับ R4T โดยเฉพาะ
Google ไม่ได้ประกาศ R4T Ranking Factor
ไม่มี R4T Schema
ไม่มี R4T Content Format
และไม่มีหลักฐานว่าต้องเขียน Content แบบใหม่เพื่อให้ระบบนี้เลือกเรา
สิ่งที่ทำได้คือเข้าใจ Direction ของ Search แล้วกลับมาตรวจหลักพื้นฐาน
Content ตอบ User Problem จริงไหม
ครอบคลุม Supporting Questions ที่จำเป็นหรือยัง
มี Original Value หรือไม่
Technical SEO ทำให้ Google Crawl และ Index ได้หรือไม่
Page Experience ใช้งานดีหรือไม่
Google เองยืนยันว่า SEO Best Practices เดิมยังเป็นพื้นฐานสำหรับการปรากฏใน AI Overviews และ AI Mode และไม่มี Technical Requirement พิเศษสำหรับ AI Search เพิ่มจากการเป็นหน้าเว็บที่ Index และแสดงใน Google Search ได้ตามปกติ
สรุป: R4T ไม่ได้ให้ SEO Trick ใหม่ แต่ช่วยให้เราเห็นทิศทางของ Search ชัดขึ้น
Query Fan-Out ไม่ใช่เรื่องใหม่
Google ใช้แนวคิดนี้ใน AI Search อยู่แล้วเพื่อช่วยแตกคำถามซับซ้อนออกเป็นหลาย Subtopics และค้นหา Supporting Information จากหลายแหล่ง
สิ่งที่ใหม่คือ Google Research กำลังหาวิธีทำกระบวนการนี้ให้ เร็วขึ้น ประหยัดขึ้น และ Scale ได้ง่ายขึ้น ผ่าน R4T-Diffusion Google Research
ตอนนี้ยังไม่มีหลักฐานว่า R4T ถูกใช้ใน Google Search ที่เราใช้อยู่จริง
แต่ในมุม SEO ผมคิดว่ามีบทเรียนที่เอาไปใช้ได้แล้ว
คืออย่ามอง Search Demand เป็น Keyword เดี่ยว ๆ มากเกินไป
เวลา Customer มีปัญหาหนึ่งอย่าง เขามักมีคำถามต่ออีกหลายเรื่อง
และ Search System เองก็กำลังเก่งขึ้นในการสำรวจคำถามเหล่านั้น
สิ่งที่เราควรทำจึงไม่ใช่สร้างหน้าใหม่ให้ทุก Fan-Out Query
แต่ถามว่า
ถ้าคนเข้ามาด้วยปัญหานี้ เขาต้องรู้อะไรบ้างเพื่อเข้าใจเรื่องนี้ดีขึ้น ตัดสินใจได้ดีขึ้น หรือทำ Progress ต่อได้?
ถ้า Content ของเราตอบเรื่องเหล่านั้นได้ดี มี Evidence ของตัวเอง และไม่ได้เขียนเพียงเพื่อจับ Keyword เพิ่ม
ไม่ว่า Google จะใช้ Retrieval Framework ตัวไหน หลักนี้ก็น่าจะยังมีประโยชน์อยู่ครับ
FAQ
Query Fan-Out คืออะไร?
Query Fan-Out คือเทคนิคที่ AI Search แตกคำถามหลักของ User ออกเป็นหลาย Related Queries เพื่อค้นหาข้อมูลจากหลาย Subtopics หรือหลายแหล่งพร้อมกัน แล้วนำผลลัพธ์กลับมาช่วยสร้างคำตอบที่ครอบคลุมขึ้น Google ระบุว่า AI Overviews และ AI Mode สามารถใช้เทคนิคนี้ได้ Google for Developers
R4T คืออะไร?
R4T หรือ Retrieve-for-Train เป็น Framework จาก Google Research ที่ใช้ Reinforcement Learning เพื่อเรียนรู้ว่า Query Fan-Out ที่ดีควรเป็นอย่างไร แล้วนำความรู้นั้นไป Train Diffusion Retriever ที่เล็กกว่าและทำงานเร็วกว่าในช่วง Retrieval Google Research
Google Search ใช้ R4T แล้วหรือยัง?
ปัจจุบัน Google ยืนยันว่า AI Mode และ AI Overviews ใช้ Query Fan-Out ได้ แต่ยังไม่มีประกาศจาก Google ว่า R4T-Diffusion ถูก Deploy ใน Google Search หรือ AI Mode แล้ว
R4T ทำให้ Query Fan-Out เร็วขึ้นเท่าไร?
Google Research รายงานว่าในชุดการทดลอง R4T-Diffusion ให้ Speedup ประมาณ 12–20 เท่าเมื่อเทียบกับ Autoregressive Approaches ที่นำมาเปรียบเทียบ อย่างไรก็ตาม ตัวเลขนี้เป็นผลของงานวิจัย ไม่ใช่ความเร็วของ Google Search ที่ผู้ใช้เห็นจริง Google Research
Query Fan-Out ทำให้ Keyword Research ไม่สำคัญแล้วหรือไม่?
ไม่ Keyword Research ยังช่วยให้เราเข้าใจ Search Demand, Vocabulary, Intent และ Commercial Value แต่ Content Planning ควรมองต่อไปถึง Customer Problem, Supporting Questions และ Subtopics ที่เกี่ยวข้องด้วย
ควรสร้าง Content แยกสำหรับทุก Fan-Out Query หรือไม่?
ไม่ Google เตือนว่าการสร้าง Page จำนวนมากเพื่อจับ Query Variation หรือ Fan-Out Query โดยไม่ได้เพิ่มคุณค่าใหม่ อาจเข้าข่าย Scaled Content Abuse ได้ ควรสร้างหน้าใหม่เมื่อ Page นั้นมี Intent และ Job ที่ชัดเจนจริง ๆ